Sebastian Raschka 上线完整的「从零实现推理模型」视频系列
译自英文
完整的 reasoning-from-scratch 视频系列现已上线(附链接):magazine.sebastianraschka.com/p…
(先短暂休息一下,11 月会带着 LLM 模型和研究动态回来!)译自英文
完整的 reasoning-from-scratch 视频系列现已上线(附链接):magazine.sebastianraschka.com/p…
(先短暂休息一下,11 月会带着 LLM 模型和研究动态回来!)译自英文
CoEvo-RSI:让不断演进的 harness 与模型能力对齐
这是一个递归自我改进框架,用双向历史继承解决“脑体不匹配”问题,让一个 9B 模型在多种智能体任务上胜过大得多的前沿模型。译自英文
云端什么时候该替端侧智能体执行,什么时候只需给建议?
我们对长程智能体执行中的端云协同做了系统研究。借助 EC²-Bench,我们在 128 个可执行任务上评估了四种协同策略,同时衡量任务完成度、资源成本和隐私暴露。
三个主要发现:
1️⃣ 云端预算小,收益大(成本效率)。端侧用 Qwen3.5-9B、云端用 GLM-5.3 时,纯端侧得分 39.12;最佳协同达到 60.46——约为纯云端(82.70)的 73%——成本仅 $8.73,约为纯云端 $56.42 的 15%。
2️⃣ 性能趋同,隐私不趋同。在 Qwen3.7-Plus 上,最佳协同得分 76.84,纯云端为 82.70;策略间差距缩小到仅 3.67 个完成度分点,但隐私暴露相差 66.23 个百分点——而且表现最好的策略泄露最多。
3️⃣ 模式随端侧能力翻转。端侧较弱时,最好用一个外部路由器让云端执行(2B……译自英文
JEPA 从看到的内容中学会该保留什么,并用它来预测接下来会发生什么。
但那些它无法预测的细节呢?模型把它们丢掉岂不是更省事?
看这个例子
想象一个随机变色的红绿灯。它下一次变成什么颜色无法预测,但它当前的颜色有助于预测骑车人会停下还是继续走。如果丢掉红绿灯,骑车人就更难预测了。
▪️ 最近一项研究把这种集合层面的视角称为“predictive closure”(预测闭包):一个特征的价值取决于它与模型所表示的其他特征之间的关系。
保留红绿灯能让骑车人更容易预测,但也给模型的预测目标加入了一个无法预测的颜色。丢掉它能去掉这个目标,却也丢失了一条有用的线索。
研究者把这两种代价区分开来:
1. 偶然不确定性(aleatoric uncertainty):即使掌握当前完整观测也仍然不确定的部分,比如红绿灯下一次随机变成的颜色。
2. 预测泄漏(predictive leakage):观测中可用的有用信息,但……译自英文
Apple 与 UCLA 推出 OpenVLHarness
这是一个无需训练的 harness,为多模态 LLM 提供能力层和持久的多模态记忆,在 22 个基准上把平均分提高了 9.7-12.6 分。译自英文
LLM 能改进自己的 harness 吗?
自我改进的 harness 是个热门话题。
一个有意思的问题是:LLM 能否自己生成并改进它们。
研究发现,把 harness 完整重写两次,留出集得分只提高 2.80 分,而且 95% 置信区间跨过零。
每个前沿模型从一个固定的编程引导程序出发写出完整的 harness,通过它玩五个开发用游戏,然后把整个代码库重写两次。每个版本都在 20 个从不影响重写的游戏上评分。
在 27 条谱系中,第一版 harness 的得分从零到接近满分不等。之后的修订几乎没有带来提升。开发游戏上的提升高估了留出集上的提升,而降低推理成本的修订往往会拉低得分。
在同样的游戏上,人类引导的系统得分仍然更高,说明更好的设计是存在的。只是模型目前还不能可靠地自己找到它们。
arxiv.org/abs/2610.30499
与论文对话:academy.dair.ai/papers/can-llms…译自英文
一项让编程智能体更有效使用技能(skills)的好工作。
(建议收藏)
在这项工作中,研究者把技能粒度当作运行时决策。对每个任务,智能体可以使用原子工具调用、宏技能,或者在失败时回退到原子步骤的宏技能。
固定的宏执行在技能匹配时很高效,不匹配时则很脆弱。
控制器根据任务结构、执行状态和此前的宏失败来选择层级,并由一个有限状态执行器把回退作为显式状态转移来处理,而不是随意重试。
在一项包含 12 个任务的路由研究中,学习得到的路由器达到 100% 成功率,而手写启发式规则会失败。借助宏到微的回退,智能体能从受控的宏失败中恢复,而固定粒度无法解决这些失败。
arxiv.org/abs/2610.31461
与论文对话:academy.dair.ai/papers/adaptive…译自英文
LEV:不多花一个 token 也能想得更深
这是一个让层循环执行的决策模型,每轮之后对选项打分。同一个检查点可在任意深度运行。在 JevBench 上,深度从 1 增加到 4 时,Lev-2.6B 的准确率从 63.2% 提升到 76.2%。vLLM 10 月 23 日博客:GB200 上按 DeepSeek 的 decode 配置,批大小 8–256 时 decode 吞吐与 DeepInfer 差距在 6% 以内;DeepInfer 数据读自其图表,非同台实测。GB300 NVL72 上用 P/D 分离加 Wide-EP,AgentX 达每 GPU 95.4 万 tokens/s,闲时价约每 GPU 小时 38.96 美元。
为什么重要:vLLM 称其在 DeepSeek-V4.1-Flash 的 decode 配置上已追平 DeepSeek 自研引擎 DeepInfer。
译自英文
DeepSeek 抬高了标杆,SGLang 把它推得更高 🧡
lmsys.org/blog/2026-10-2…
欢迎阅读我们的博客,了解性能结果、工程优化,以及 SGLang 如何把这一切整合成可用于生产的推理服务栈!x.com/sgl_project/st…
用桌面图形界面查找、下载和运行本地大模型
本地 AI 与模型v0.4.28
Anthropic 回放 Mythos 5 测试事故时发现,攻击一旦进入中后段,模型几乎从不主动收手。它的假说是:模型把自己写的交接笔记当成了许可。刹车得装在智能体够不着的地方。
月之暗面发布 Kimi K3.1 Pro,基于 K3 后训练,支持 100 万 token 上下文,已上线 Kimi 各端和 API,计划 11 月 4 日前开放权重。官方自测 Terminal-Bench 4.0 得分 65.7%,内部幻觉率由 23.4% 降至 8.3%。公司剔除了网络攻击相关训练数据:xdev-bench-hard 上发布版得分 81.0%,未过滤版本为 90.5%。
为什么重要:月之暗面公开以牺牲部分能力为代价,压低模型的攻击性网络能力,回应了外界对开放权重被滥用的担忧;基准分数均为官方自测,尚待第三方验证。
腾讯办公智能体 WorkBuddy 10 月 24 日宣布接入月之暗面新模型 Kimi-K3.1-Pro,支持 100 万 token 上下文。同时上线 Highspeed 版本,腾讯称其智能水平相同、输出速度约为 2 至 3 倍。因算力资源紧张,新模型优先向企业旗舰版和个人订阅用户开放。速度数据为腾讯单方说法。
为什么重要:Kimi K3.1 Pro 发布后迅速进入腾讯的办公产品,说明中国大型互联网平台愿意在自家应用中接入第三方模型;算力紧张导致分级开放,也反映出长上下文模型的推理成本压力。
亚马逊 CEO 安迪·贾西在 a16z 播客中表示,AWS 今年的算力已经售罄,2027 年的容量也基本被预订,2028 年也已售出相当一部分,公司仍会保留部分容量用于按需 EC2 和 Bedrock。亚马逊今年资本开支预计约 2200 亿美元,将于 10 月 29 日公布第三季度财报。
为什么重要:在市场质疑 AI 投入回报之际,最大云厂商给出需求远超供给的信号,将影响投资者对下周科技巨头财报和算力投资的判断。
10 月 24 日,多个品牌的企业微信账号被网友发现向客户发送疑似色情引流信息。企业微信安全团队当天公告称,原因是某第三方外挂软件服务被攻破,使用该服务的账号受到影响,平台已强制下线相关账号并封禁引流链接,同时表示将持续清理“多开”“群控”类外挂并处理违规使用者。
为什么重要:大量企业为了“多开”“群控”接入非官方工具,一旦这类工具被攻破,攻击者就能直接冒用品牌账号触达客户;这提醒企业审视第三方插件带来的账号与客户数据风险。
Firecrawl 宣布 Alexandria 新增梦幻篮球数据,可向 ChatGPT 或 Claude 提供每位 NBA 球员的预测、专家排名、伤病更新和新闻,通过 Firecrawl 插件使用。
为什么重要:Firecrawl 的 Alexandria 数据目录新增 NBA 梦幻篮球数据,ChatGPT 或 Claude 可通过 Firecrawl 插件获取球员预测、排名、伤病和新闻。
TypingMind 官方宣布,使用 OpenAI 模型时现已支持 12 小时的提示缓存(prompt caching)。
为什么重要:TypingMind 对 OpenAI 模型支持 12 小时提示缓存,重复使用长提示时可减少重复计费和等待。
Bun 官方公布了影响 1.4.3 及更早版本的三项安全公告:eMudhra 证书被攻破、brotli 解码器漏洞(HTTP2Shell),以及 HTTP/3「Header Accordions」攻击。三项均已在 Bun 1.4.4 修复,官方建议运行 bun upgrade 升级,并重新构建用 bun build --compile 打包的程序。
为什么重要:Bun 1.4.3 及更早版本存在三个安全问题(证书、brotli 解码越界写、HTTP/3 攻击),1.4.4 已修复,用户需升级并重新编译 bun build --compile 产物。
Ollama 模型库新增 nemotron-3.5-bolt:e4b,下载约 7.2–7.9GB,128K 上下文,支持文本与图像输入和工具调用。该模型由 NVIDIA 基于 Gemma 4 E4B 后训练(8B 参数,4B 有效),面向本地助手等场景,运行命令为 ollama run nemotron-3.5-bolt:e4b。推文中的“4GB”出自 NVIDIA 模型名,并非下载大小。
为什么重要:NVIDIA 的 4GB 小型开放模型 Nemotron 3.5 Bolt E4B 可在 Ollama 本地运行,面向本地助手、对话角色和机器人的工具调用场景。
Ollama 新增文本转语音能力,首个语音模型是 Gradium 的小型 TTS 模型系列 Phonon,目前支持 macOS,Windows 和 Linux 即将支持。 在 Apple Silicon 上,Ollama 借助 MLX 加速,称在 M5 Max 版 MacBook Pro 上比 Gradium 自家运行时快 35%,词错误率与参考实现持平。Phonon 支持英、法、德、西、葡五种语言和多种音色,兼容 OpenAI 的语音接口;主模型采用 Apache 2.0 许可,40M 小模型限非商业使用。
原文Ollama can now turn text into speech.
 Ollama官方博客
Buttondown 对作者使用的写作和管理后台做了一轮无障碍改进。 屏幕阅读器方面,新增跳到正文的链接和页面地标,约 25 个纯图标按钮补上了可读名称;键盘方面,表格可用方向键逐行移动,文件行、分析列等元素均支持键盘操作。团队接下来将改进文字对比度、焦点轮廓、Windows 高对比度模式,并对照 WCAG 2.2 检查。
原文This time, we turned that lens on ourselves: the app you use to write, send, and manage your newsletter.
 Buttondown官方博客
Paperclip v2026.1023.0 允许把任务或项目设为私有并共享给指定的人和 agent,其他人无法打开、搜索、读取运行记录或通过插件访问。agent 可通过自有模型网关运行,支持 OpenRouter、Amazon Bedrock、Google Gemini 和兼容 OpenAI 或 Anthropic 接口的端点;Costs 页面改为精确账本,并显示月度订阅费用。 Operator 角色预设从 1 项权限扩大到 14 项,可创建和配置 agent,管理员应检查成员角色。GitHub 审查机器人移到默认关闭的实验设置之后,已有机器人继续运行。
 PaperclipGitHub 版本发布
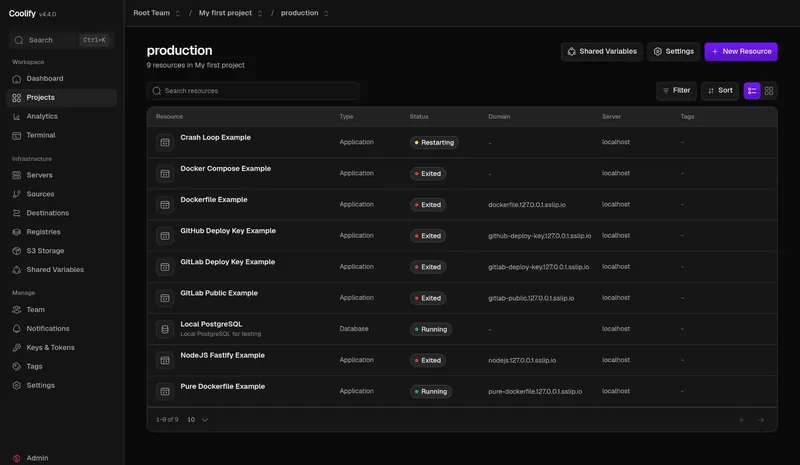
Coolify v4.5.0 新增 Gitea App 源,可部署私有 Gitea 仓库;新增服务器补丁功能(beta),可按服务器自动安装安全更新;新的舰队指标页汇总服务器和容器的表格与趋势图。 这一版还新增 Passkey 登录、应用和服务的文件浏览器,以及更新前自动备份 Coolify 数据库。安全方面,明文密钥改为静态加密存储;不兼容变更包括 API token 需要 deploy 权限才能运行计划任务等操作,POST /api/v1/enable 接口已移除。
 CoolifyGitHub 版本发布
本条来自官方博客(lobehub.com),发布于 。查看原文
 LobeHub官方博客
Hindsight v1.1.0 加入统一的决策模型配置,可按操作单独覆盖,提供方新增 Cloudflare Clef 和 OpenAI Decisions API;配置了决策模型后,recall 会用它来排序。LLM 请求扩展可在服务端为每次调用选择 LLM 和凭据。 文档搜索可以检索正文,并显示哪些字段命中。webhook 事件加入投递 ID;此外还修复了 Windows 上导出轮询超时、未知 tags_match 被放宽为 any 等问题。
 HindsightGitHub 版本发布
智能体记忆项目 Hindsight 在其评测体系中把英伟达 Nemotron 3.5 Embed 与另外 7 个嵌入模型对比,包括 OpenAI text-embedding-3-small、BGE-M3 和 Qwen3-Embedding-0.6B。Hindsight 称 Nemotron 在 LoCoMo 和 BEAM 100K 记忆检索上分别取得 93.8% 和 65.9%,均列第一。 得益于 32768 个 token 的上下文,Nemotron 能完整嵌入对话原文段落,在 BEAM 千万 token 档的 recall@10 为 38.0%,在 8 种语言 27 项检索任务上平均 nDCG@10 为 55.1。在单张英伟达 L4 上每次查询约 30 毫秒,比参数量约为其一半的 Qwen3-Embedding-0.6B 更快。
原文Nemotron finished first on memory retrieval and first on the leaderboard, and it answered queries faster than a model just over half its size.
Hindsight官方博客本条来自官方博客(huggingface.co),发布于 。查看原文
 Hugging Face官方博客
marimo 介绍了两支获奖黑客松团队:Standard Physics 在 CoreWeave Hacks 拿下 marimo 赛道和“最具生产可用性”奖,MIKMAK 在一场实验室自动化黑客松获总冠军。 Standard Physics 的应用把手机扫描变成 3D 房间模型,帮小商家排查无障碍问题,调整家具即可实时看到检查结果;MIKMAK 让智能体设计针对 TEM-1 酶的抑制实验并驱动机器人执行,科学家在 marimo 界面中审批计划、复盘运行记录。
原文Their project connected agent-proposed experiments, physical laboratory runs, and analysis.
 marimo官方博客
Impeccable skill v4.7.0 可对以调试端口启动的 Electron、NW.js、CEF 或 WebView2 应用做 critique 和 audit,扫描当前打开的窗口且不改动应用。新增两项排版检查:straggler 检查段落末行只剩一个词,unbalanced-heading 检查标题末行过短。 常驻每个会话的技能描述缩短 30%,并能识别编写 DESIGN.md 的请求。决策和评审页面会跟随系统深色模式,monorepo 中只把渲染界面的 workspace 列为目标。
 ImpeccableGitHub 版本发布
Easydict 2.25.0 新增 Anki Connect 集成,配置项放在单独的设置面板中。DeepL 客户端版本已更新以恢复翻译兼容性,DeepL 还新增希伯来语和泰语支持。 Gemini 改用 OpenAI 格式。查询窗口的尺寸调整和文本渲染更加稳定。
 EasydictGitHub 版本发布
Ollama 宣布上线 Cloudflare 的多模态决策模型 Clef,用户可本地运行或使用 Ollama 云端。 Clef 参数量 27B,基于 Qwen3.8-27B 微调,采用 Apache 2.0 许可,可一次读取文本、JSON 或图片并同时为所有问题的答案打分,适用于请求路由、条件判断、策略执行、文档字段识别和工具调用审核。Ollama 引用 Cloudflare 的数据称,Clef 在其决策指数上排名第一。
原文Clef turns a state and a schema of typed questions into decisions.
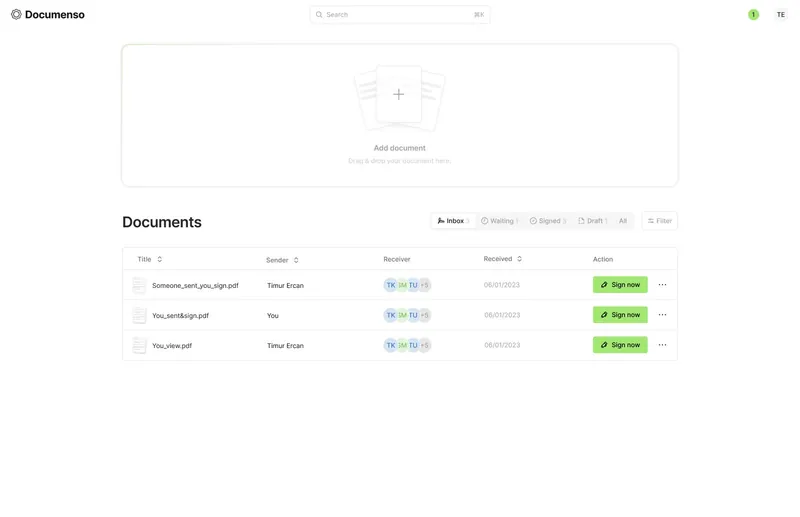
Ollama官方博客Documenso v2.21.0 会在账户被举报时停用该账户,并显示新账户警告。 这一版还修复了 v1 多方签署在可选字段为空时无法完成的问题。
 DocumensoGitHub 版本发布
本条来自官方博客(affine.pro),发布于 。查看原文
 AFFiNE官方博客
本条来自官方博客(affine.pro),发布于 。查看原文
AFFiNE官方博客本条来自官方博客(affine.pro),发布于 。查看原文
AFFiNE官方博客本条来自官方博客(affine.pro),发布于 。查看原文
AFFiNE官方博客


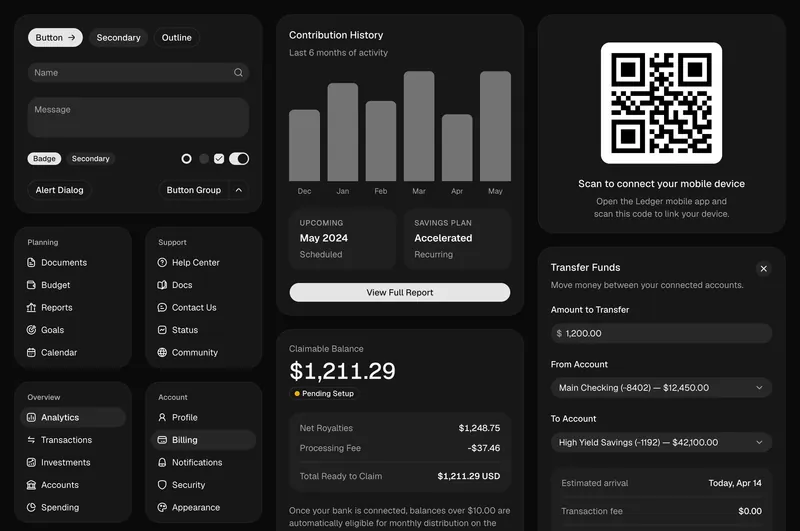
 shadcn/ui